2026-10-15 14:15 - 15:00 A 會議室
AI O11y:數據決策到技術選型
LLM application 與 AI agent 的問題,通常不只是在服務是否存活。當模型輸出品質下降、latency 變高或成本突然增加時,團隊需要知道每一次 request 經過了哪些步驟、使用了什麼模型與 prompt,以及最後產生了什麼結果。傳統的 logging 與 metrics 往往不足以回答這些問題。
本次分享將介紹 LLM observability 的基本概念,並以 Langfuse 為例,示範如何建立 tracing、觀察 model call 與 agent workflow,從 traces 中分析品質、延遲與成本,逐步建立可供開發與維運使用的 feedback loop。
1. 為什麼 LLM application 需要新的 observability
2. Trace、span、generation 與 metadata
3. 使用 Langfuse 收集與查看 LLM traces
4. 從 tracing 分析 latency、token usage 與成本
5. 觀察 prompt、model output 與 agent workflow
6. Observability 的限制:如何走向 evaluation 與 decision system
聽眾收穫:
你將能理解 LLM tracing 與傳統服務 observability 的差異,使用 Langfuse 追蹤模型呼叫與 agent workflow,並從 traces 取得品質、延遲與成本分析所需的資料,為後續 evaluation 與 regression 建立基礎。
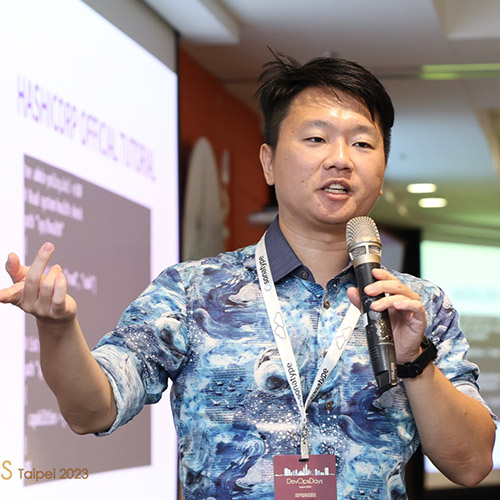
張哲嘉 (Che Chia Chang)
MaiCoin
SRE
Che-Chia Chang 是一名專注於後端開發、開發維運、容器化應用及 Kubernetes 開發與管理的技術專家,同時也是 Microsoft 最有價值專業人士(MVP)。
活躍於台灣技術社群,經常在 CNTUG、DevOps Taipei、GDG Taipei、Golang Taipei Meetup 等社群分享 DevOps、SRE、Kubernetes、雲端與 AI Engineering 相關技術。
個人部落格:https://chechia.net
- LEVEL
- 中階
- LANGUAGE
- 中文
- SUBTOPIC
- 探索 AI 共生共創的面向
- TAGS
- AI 如何改變產品規劃與需求定義